Cybersecurity Metrics สำหรับทีมเล็ก: วัดอะไรดีถ้าไม่มี SOC เต็มรูปแบบ
ทีมเล็กไม่จำเป็นต้องมี dashboard หลายสิบตัวเพื่อรู้ว่าความปลอดภัยดีขึ้นหรือแย่ลง ลองเริ่มจากอายุ patch, MFA ของบัญชีสำคัญ, ผล restore, การซ้อมเหตุการณ์ และ vendor ที่ขาดการทบทวน
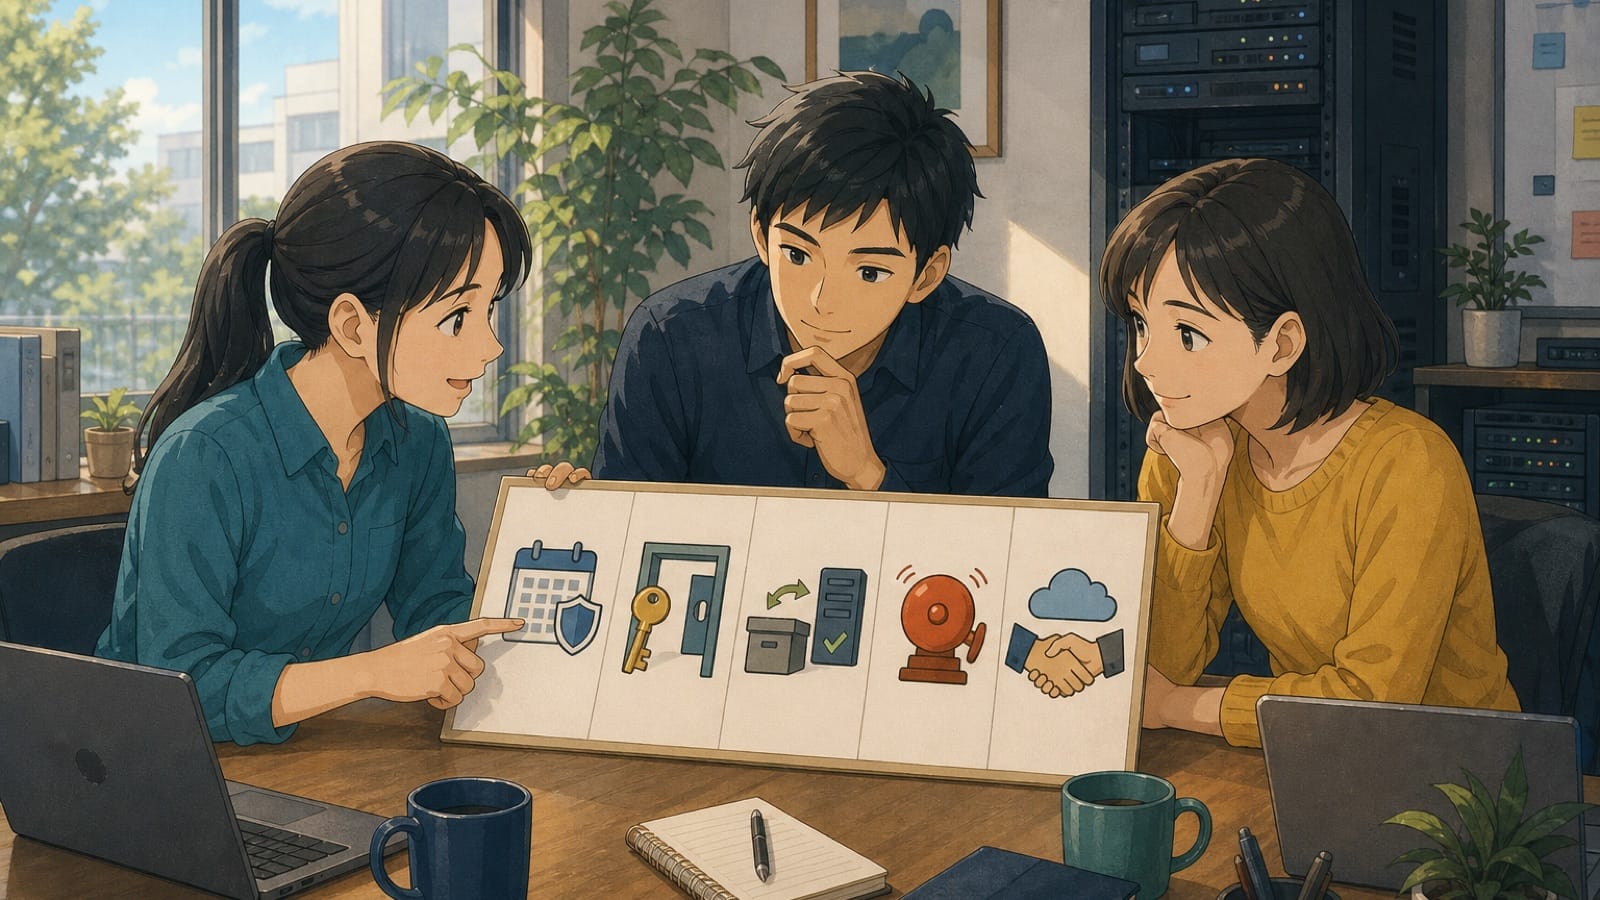
ถ้าทีมเล็กมีเวลาประชุมเรื่อง security เดือนละครั้ง ผมคงไม่อยากใช้เวลานั้นไล่ดู dashboard ที่มี alert หลายร้อยรายการครับ คำถามที่อยากได้คำตอบมากกว่าคือ เดือนนี้มีจุดไหนที่ปล่อยค้างอยู่จนควรหยิบมาทำก่อนงานอื่น และถ้าเกิดเรื่องขึ้น เราจะรู้ไหมว่าของที่เตรียมไว้ใช้ได้จริง
Cybersecurity metric สำหรับทีมเล็กจึงไม่จำเป็นต้องเป็นคะแนนความปลอดภัยของบริษัท และไม่ต้องพยายามนับทุกอย่างที่เครื่องมือมองเห็นด้วย จุดประสงค์ของมันค่อนข้างธรรมดา: ทำให้คนในทีมเห็นความเสี่ยงที่สำคัญพอจะตัดสินใจลงมือแก้ได้ทันเวลา
ลองนึกถึง spreadsheet หนึ่งหน้า มีแถวสำหรับ email, ระบบบัญชี, file storage, VPN และบริการ cloud ที่ใช้ทำงานอยู่ทุกวัน ถ้าผมเป็นคนดูแล ผมจะยังไม่เพิ่มกราฟสีสวย ๆ เข้าไปก่อน แต่จะเริ่มถามทีละแถวว่า บัญชี admin เปิด MFA ครบหรือยัง, patch สำคัญค้างมากี่วัน, backup ของระบบนี้เคยกู้แล้วเปิดใช้งานได้ไหม, ถ้าบัญชีถูกยึดใครโทรหาใคร และ vendor ที่เราพึ่งอยู่มี contact หรือทางออกหากต้องย้ายหรือเปล่า
คำตอบห้าชุดนี้พอจะเป็นจุดเริ่มของ dashboard ที่ดูแลต่อไหวแล้วครับ
ตัวเลขที่ดีต้องทำให้ตัดสินใจต่างออกไป
ตัวเลขอย่าง “blocked attacks วันนี้” หรือ “log ที่รับเข้ามากี่ GB” ไม่ได้ไร้ประโยชน์ มันช่วยคนดูแลระบบรู้ว่ามีอะไรเกิดขึ้น แต่ถ้าทีมเล็กไม่มีคนเฝ้าหน้าจอทั้งวัน ตัวเลขเหล่านี้มักไม่บอกว่าพรุ่งนี้ควรทำอะไรต่อ
ผมจะเลือก metric ก็ต่อเมื่อเขียนประโยคต่อท้ายมันได้ เช่น “ถ้าเกินค่านี้ เราจะอัปเดตเครื่องไหนก่อน” หรือ “ถ้ารอบนี้ยังไม่ผ่าน ใครต้องนัดซ้อมกู้ข้อมูล” ถ้าตอบไม่ได้ ก็เก็บตัวเลขนั้นไว้ในรายงานดิบก่อนได้ ไม่จำเป็นต้องยกขึ้นมาบนหน้าหลัก
ก่อนบันทึกค่าแต่ละตัว ให้เขียนกำกับสั้น ๆ ไว้ด้วยว่ากำลังนับอะไร ไม่ได้นับอะไร ดึงข้อมูลจากไหน ใครตามเรื่อง และเมื่อไรค่าที่แย่ลงจะต้องกลายเป็นงานจริง วิธีนี้ช่วยตัดปัญหา “MFA เรา 100% แล้ว” ทั้งที่ตัวเลขนั้นนับเฉพาะพนักงาน แต่ยังไม่รวมบัญชี admin หรือบัญชีของ vendor ที่เข้ามาช่วยดูแลระบบ
NIST CSF 2.0 วางเรื่องการประเมินผลไว้เพื่อช่วยปรับการจัดการความเสี่ยง ไม่ได้บอกให้ทุกองค์กรสร้าง security score ก้อนเดียว ส่วน CIS Controls ก็เน้นการควบคุมที่จัดลำดับและวัดผลได้ NIST CSF 2.0 และ CIS Controls v8 จึงเป็นกรอบคิดที่มีประโยชน์ แต่ตอนเริ่มจริง ๆ ผมยังเลือกดูของที่ทีมทำงานด้วยทุกวันก่อนอยู่ดี
เริ่มที่เครื่องและบัญชีที่ถ้าพังแล้วงานสะดุด
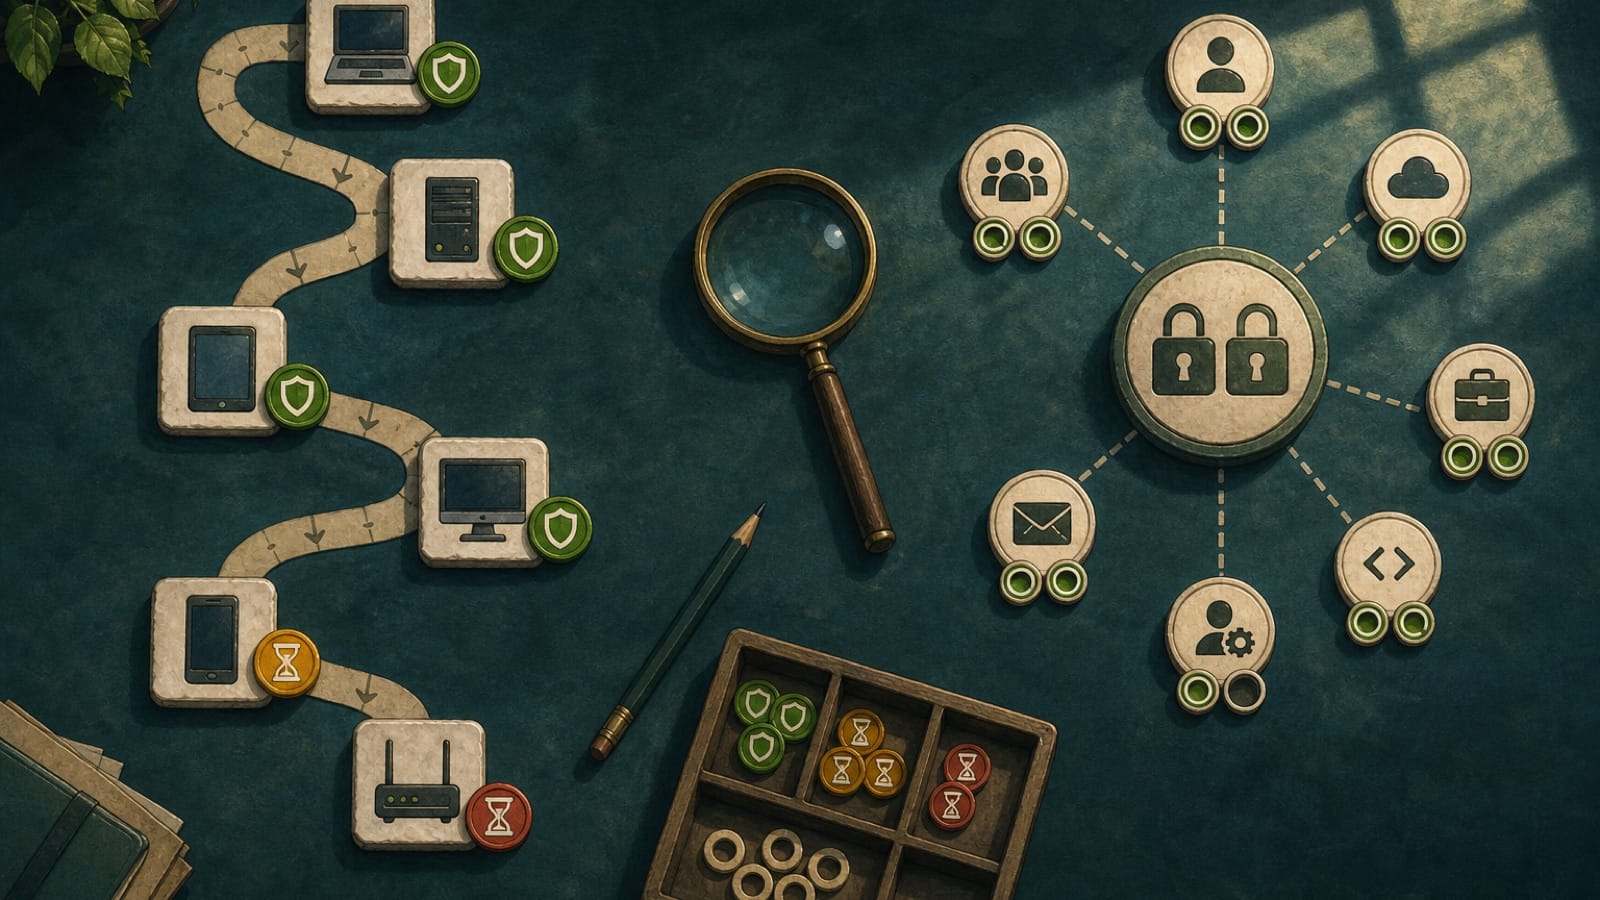
ตัวแรกที่ผมมักอยากเห็นคืออายุของ patch สำคัญ ไม่ใช่จำนวนช่องโหว่ทั้งหมดในรายงาน เพราะรายการเดียวอาจซ้ำอยู่หลายเครื่อง และระดับความรุนแรงจาก scanner ก็ยังไม่รู้ว่าระบบนั้นเปิดออกอินเทอร์เน็ตหรือเกี่ยวกับงานหลักแค่ไหน
ใน spreadsheet ข้างต้น อาจบันทึกเพียงจำนวนเครื่องหรือบริการสำคัญที่เกินกรอบเวลาซึ่งทีมตั้งไว้ พร้อมจำนวนวันที่เกิน ไม่ต้องตั้งกรอบเดียวกันทุกอย่างก็ได้ เครื่องที่เปิดให้ลูกค้าหรือพนักงานเข้าจากภายนอกย่อมต่างจากเครื่องเก่าที่ใช้เปิดเอกสารภายในเดือนละครั้ง หากต้องรอทดสอบกับระบบ legacy ก็ให้ใส่วันหมดอายุของข้อยกเว้นและวิธีลดความเสี่ยงไว้ด้วย ไม่อย่างนั้นคำว่า “กำลังดำเนินการ” มักอยู่ได้นานเกินควร
ตัวเลขนี้ใช้ได้เมื่อเราเห็นรายการทรัพย์สินพอสมควรเท่านั้น ถ้ายังมี laptop, server หรือ SaaS หลุดจากรายการ ค่า patch ที่ดูดีอาจดีแค่ในส่วนที่เครื่องมือมองเห็น Patch Management ใน Homelab มีแนวคิดเรื่องจังหวะอัปเดตและการเตรียม rollback ที่เอามาปรับกับทีมเล็กได้
ถัดมาคือ MFA แต่ผมจะไม่เริ่มจากการไล่ถามทุกบัญชีพร้อมกัน เริ่มจากบัญชีที่ถ้าโดนยึดแล้วปัญหาใหญ่กว่า เช่น email, cloud admin, ระบบการเงิน, source code, remote access และ password manager แล้วแยกผู้ใช้ทั่วไปออกจาก admin ให้เห็นเลย
สูตรร้อยละของบัญชีที่เปิด MFA ฟังตรงไปตรงมา แต่สิ่งที่น่าดูมักเป็นบัญชีที่อยู่นอกสูตร: account เก่าที่ไม่มี owner, recovery method ที่อ่อนกว่าการ sign-in ปกติ หรือ service account ที่ใช้ MFA ไม่ได้ บัญชี admin หนึ่งบัญชีที่ยังใช้ password อย่างเดียวมีความหมายมากกว่าค่า coverage ที่ปัดเป็น 99% ครับ ทำไม MFA ยังสำคัญ แม้หลายคนจะเริ่มรำคาญกับมัน อธิบายเหตุผลที่ต้องยอมแลกความสะดวกบางส่วนไว้ละเอียดกว่า
สีเขียวของ backup ยังไม่ใช่คำตอบ
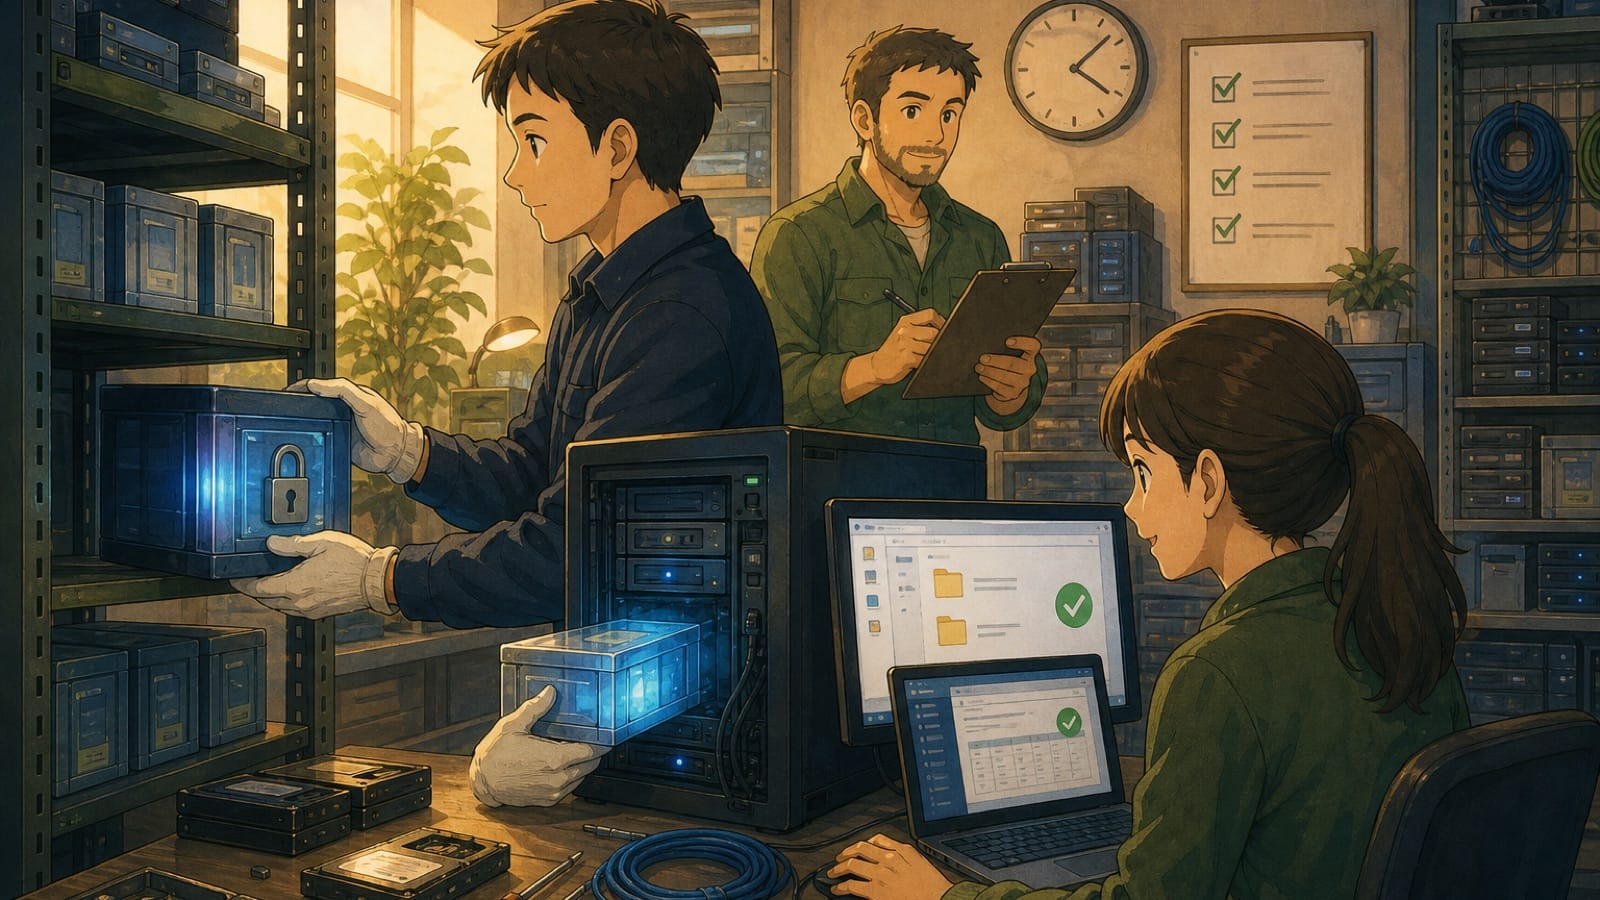
มี metric บางตัวที่ผมระวังเป็นพิเศษ เพราะมันทำให้รู้สึกสบายใจก่อนเวลาอันควร สถานะ backup job สีเขียวเป็นตัวอย่างที่ชัดมาก มันบอกว่างานสำรองข้อมูลจบตามที่เครื่องมือคาดไว้ แต่ไม่ยืนยันว่าไฟล์อ่านได้, key ถอดรหัสยังอยู่, database เปิดกับโปรแกรมรุ่นปัจจุบันได้ หรือคนในทีมรู้ขั้นตอนกู้จริง
ถ้าใน spreadsheet มีระบบบัญชีหนึ่งระบบ ผมจะไม่เขียนเพียงว่า “backup: ผ่าน” แต่จะบันทึกวันที่ restore ล่าสุดด้วย ว่ากู้สำเนาชุดไหนไปไว้ที่ใด ใช้เวลานานเท่าไร และเจ้าของงานเปิดรายงานหรือทำรายการตัวอย่างได้หรือไม่ จุดที่ติด เช่น permission, ไฟล์แนบ, secret, dependency หรือคู่มือที่ตามไม่เจอ ควรถูกเขียนไว้ข้างผลทดสอบเลย เพราะนั่นต่างหากคือรายการที่ต้องแก้
ไม่จำเป็นต้องกู้ production เต็มระบบทุกเดือน การเริ่มจากข้อมูลหรือบริการสำคัญหนึ่งรายการในพื้นที่ทดสอบที่แยกออกมาก็พอแล้ว ความถี่และความลึกควรตามผลกระทบ ถ้าระบบหยุดแล้วออก invoice ไม่ได้ทั้งวัน ก็ย่อมควรให้ความสำคัญมากกว่า archive ที่แทบไม่เคยเปิด แนวคิดการจัดสำเนาอ่านต่อได้ที่ 3-2-1 Backup Strategy สำหรับ Homelab
แผนกับ vendor ต้องถูกเรียกใช้ได้ในวันแย่ ๆ
เอกสาร incident response plan ที่ถูกเก็บไว้ใน drive ไม่ได้บอกว่าทีมพร้อมตอบสนองแค่ไหนเหมือนกันครับ สิ่งที่น่ารู้กว่าคือซ้อมสถานการณ์ที่มีความหมายครั้งล่าสุดเมื่อไร และงานที่พบจากการซ้อมยังค้างกี่เรื่อง
ทีม 3–10 คนไม่ต้องจัด simulation ใหญ่โต ลองนั่งคุยกันหนึ่งชั่วโมงจากเหตุการณ์ใกล้ตัว เช่น บัญชี email ถูกยึด, file server ถูกล็อก หรือ SaaS สำคัญล่ม แล้วดูว่าใครมีสิทธิ์ตัดสินใจ ใครติดต่อ vendor ใครคุยกับลูกค้า และมี contact กับ runbook อยู่ที่ไหน ถ้าการหาหมายเลขโทรศัพท์ของผู้ให้บริการใช้เวลานานกว่าที่คาด หรือไม่มีใครแน่ใจว่าควรปิดบัญชีตรงไหน นั่นเป็นผลลัพธ์ที่ดีกว่าการประชุมที่จบด้วยคำว่า “น่าจะทำได้”
ตัวเลขที่ผมจะเก็บจึงเรียบง่าย: วันที่ซ้อมล่าสุด, คนที่ควรอยู่เข้าร่วมหรือไม่, และงานแก้ที่ยังเปิดอยู่ ไม่ต้องพยายามวัดให้เหมือน SOC เพียงทำให้รอบถัดไปเห็นได้ว่างานค้างถูกปิดจริงไหม Incident Response สำหรับ SME ที่ไม่มี SOC เป็นจุดเริ่มที่ดีถ้าทีมยังไม่มีขั้นตอนพื้นฐาน
เรื่องนี้ต่อกับ vendor โดยตรง เพราะธุรกิจขนาดเล็กมักพึ่ง email, cloud, payment, MSP หรือบริการเฉพาะทางมากกว่าระบบที่อยู่ในห้อง server ของตัวเอง ผมจะไม่ส่งแบบสอบถามยาวเท่ากันให้ทุกเจ้า แต่จะวงไว้ก่อนว่า vendor ไหนหยุดแล้วงานหลักหยุด หรือ vendor ไหนถือข้อมูลสำคัญ จากนั้นดูว่าใครเป็นคนดูแลความสัมพันธ์นั้น, ทบทวนครั้งล่าสุดเมื่อไร, มี contact สำหรับ incident ไหม และถ้าต้องย้ายออกเราดึงข้อมูลหรือทำงานต่ออย่างไร
NIST CSF 2.0 ให้ความสำคัญกับการจัดลำดับ supplier และติดตามความเสี่ยงตลอดความสัมพันธ์ ซึ่งเข้ากับวิธีทำงานนี้พอดี ไม่ต้องไล่ขอเอกสารทุกฉบับก่อน แต่ก็ไม่ควรรอให้เกิดเหตุแล้วค่อยค้นหาเจ้าของบริการ
หนึ่งหน้าที่เปิดแล้วรู้ว่าจะทำอะไรต่อ
สำหรับรอบแรก ผมจะหยุดที่ห้าตัวนี้ก่อน: patch ที่ค้างเกินกรอบ, MFA ของบัญชีสำคัญ, วันที่และผล restore ล่าสุด, การซ้อม incident กับงานค้าง, และ vendor สำคัญที่ยังไม่ถูกทบทวน แถวหนึ่งใน dashboard ควรมีค่าปัจจุบัน แนวโน้มช่วงหลัง ขอบเขต และประโยคสั้น ๆ ว่าใครทำอะไรต่อ ไม่จำเป็นต้องมีทุกสีของ traffic light ถ้าสีไม่ได้ช่วยให้คนอ่านรู้เหตุผล
ช่วงสองสามเดือนแรกอย่าเพิ่งเอาค่าไปเทียบกับองค์กรอื่นจนรีบตั้งเป้าที่ดูดีบนสไลด์ เก็บ baseline ของตัวเองก่อน แล้วดูว่าตัวเลขพาไปเจออะไร เช่น admin account หนึ่งบัญชี, เครื่องที่ต้องทดสอบก่อนอัปเดต, backup ที่ไม่เคยถูกเปิด หรือ vendor ที่ไม่มีทางติดต่อเร่งด่วนเลย สิ่งเหล่านี้อาจไม่สวย แต่มีประโยชน์ เพราะมันบอกลำดับงานต่อไปได้
หลังประชุม ให้หยิบแถวที่น่ากังวลที่สุดเพียงหนึ่งหรือสองแถวมาแปลงเป็นงาน มีคนรับผิดชอบและวันกลับมาดูผลก็พอ ถ้าพยายามปิดทุกช่องว่างในเดือนแรก dashboard จะกลายเป็นรายการที่ทุกคนเลื่อนผ่านเหมือน alert อีกชุดหนึ่ง
สุดท้าย metric ไม่ได้พิสูจน์ว่าทีมปลอดภัย และห้าตัวนี้ก็ไม่ได้ครอบคลุมความเสี่ยงทุกแบบ แต่ถ้ามันทำให้ทีมรู้ว่าต้องอัปเดตอะไรก่อน ปิดบัญชีไหน ทดลองกู้อะไร หรือนัดคุยกับ vendor รายใด มันก็ทำหน้าที่ของมันแล้วครับ
อ่านต่อที่เกี่ยวข้อง
- Incident Response สำหรับ SME: ถ้าไม่มี SOC ควรเริ่มเตรียมจากอะไรบ้าง
- Patch Management ใน Homelab: อัปเดตบ่อยแค่ไหนถึงจะปลอดภัยและไม่พังเอง
- ทำไม MFA ยังสำคัญ แม้หลายคนจะเริ่มรำคาญกับมัน
- 3-2-1 Backup Strategy สำหรับ Homelab