Backup Restore Drill: สำรองข้อมูลแล้วต้องลองกู้คืนจริง
Backup ที่ทำงานทุกคืนยังไม่พอ หากไม่เคยลองกู้คืน บทความนี้ชวนทีมเล็กซ้อม restore แบบปลอดภัย วัดเวลาจริง และตรวจว่าข้อมูลกลับมาใช้ทำงานได้
คำถามเรื่อง backup ที่ผมคิดว่าตอบยากกว่าคำถามว่า “สำรองสำเร็จไหม” คือ ถ้าต้นฉบับหายวันนี้ เราจะเอาสำเนานั้นกลับมาใช้ทำงานได้จริงหรือเปล่า
หน้าจอสีเขียวบอกได้ว่า job ทำงานจบตามเงื่อนไขของเครื่องมือ แต่ยังไม่บอกว่าไฟล์สำคัญถูกเก็บครบ กุญแจถอดรหัสยังหาเจอ โปรแกรมรุ่นปัจจุบันยังอ่านข้อมูลเดิมได้ หรือทีมจะใช้เวลากี่ชั่วโมงกว่าจะกลับมาออกใบแจ้งหนี้ รับคำสั่งซื้อ หรือเปิดเอกสารลูกค้าได้อีกครั้ง
วิธีหาคำตอบไม่จำเป็นต้องเริ่มจากการปิดระบบจริงทั้งบริษัทครับ ทีมเล็กเลือกข้อมูลหรือบริการสำคัญหนึ่งรายการ กู้ไปยังพื้นที่ทดสอบที่แยกจาก production แล้วให้คนที่ใช้งานข้อมูลนั้นตรวจผล แค่นี้ก็เริ่มเห็นแล้วว่า backup ที่มีอยู่เป็นทางกลับบ้าน หรือเป็นเพียงกล่องที่เรายังไม่เคยลองเปิด
ลองตามระบบออกใบแจ้งหนี้หนึ่งระบบ
สมมติว่าธุรกิจสำรอง database ของระบบออก invoice ทุกคืน เมื่อมองจาก dashboard ทุกอย่างเรียบร้อย แต่พอลองกู้จึงพบว่าไฟล์แนบอยู่ใน object storage อีกแห่ง โปรแกรมรุ่นใหม่อ่าน schema เก่าไม่ได้ และ secret สำหรับเชื่อม database อยู่บนเครื่องต้นทางที่เสียไปแล้ว
ในทางเทคนิคอาจพูดได้ว่า backup database สำเร็จ แต่ในทางธุรกิจยังออก invoice ไม่ได้ นี่เป็นเหตุผลที่ผมให้น้ำหนักกับผลลัพธ์ปลายทางมากกว่าสถานะของ job: ผู้ใช้ที่เกี่ยวข้องต้องเปิดข้อมูล ตรวจยอด หรือทำรายการตัวอย่างได้ โดยไม่แตะข้อมูลจริง
บทความ Backup 3-2-1 แบบเข้าใจง่าย อธิบายเรื่องจำนวนสำเนาและการแยกที่เก็บไว้แล้ว ส่วน restore drill คือขั้นถัดมา เมื่อมีสำเนา เราต้องพิสูจน์ว่าสำเนานั้นพางานกลับมาได้
ก่อนจับเวลา ต้องรู้ว่าเรายอมเสียอะไรได้แค่ไหน
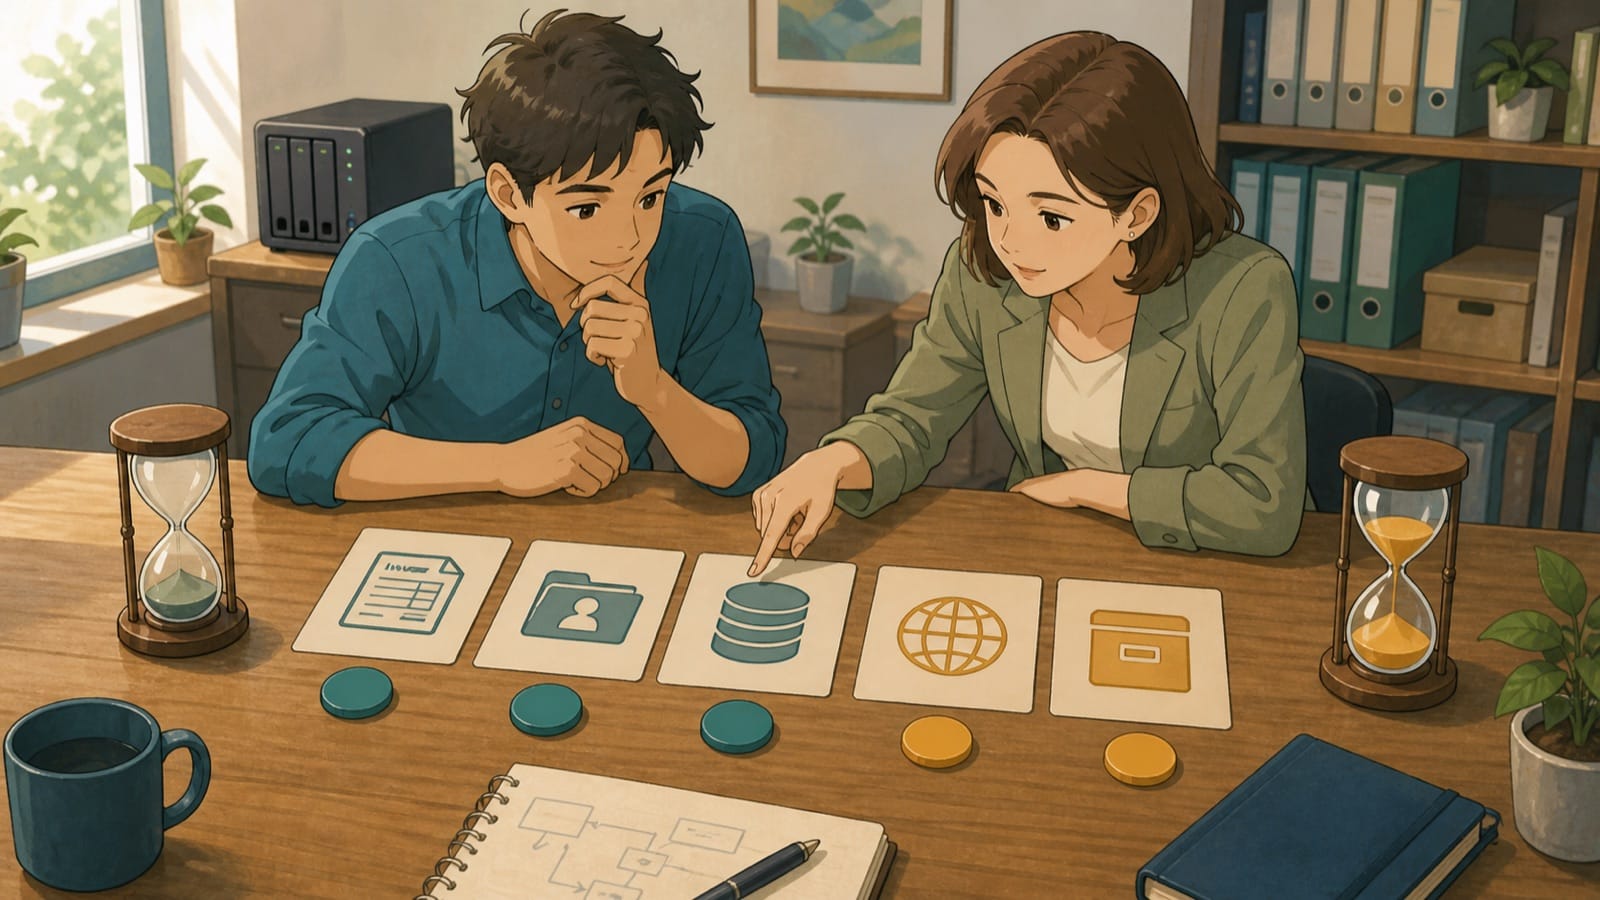
ศัพท์สองคำที่มักโผล่มาในเรื่องนี้คือ RPO และ RTO ฟังดูเป็นภาษาขององค์กรใหญ่ แต่ความหมายใช้งานตรงไปตรงมามาก
Recovery Point Objective (RPO) ถามว่า เรายอมย้อนกลับไปใช้ข้อมูลเก่าได้แค่ไหน ถ้าระบบหยุดตอนสี่โมงเย็น แต่สำเนาล่าสุดมาจากเมื่อคืน ข้อมูลของวันนี้ที่หายไปยอมรับได้หรือไม่
Recovery Time Objective (RTO) ถามว่า งานหยุดได้นานเท่าไรก่อนผลกระทบจะหนักเกินรับ ถ้าระบบออก invoice ใช้ไม่ได้หนึ่งวัน ทีมมีวิธีออกเอกสารชั่วคราวหรือธุรกิจต้องหยุดรอ
ผมไม่แนะนำให้เริ่มจากตัวเลขที่ฟังดูดี เช่น “ทุกระบบต้องกลับมาภายในหนึ่งชั่วโมง” เพราะระบบเก็บเอกสารเก่าไม่จำเป็นต้องได้เป้าเดียวกับระบบรับเงิน และเป้าที่ไม่มีทั้งคน งบ หรือเทคโนโลยีรองรับก็ไม่ได้ช่วยในวันเกิดเหตุ สิ่งที่ควรมีคือความต้องการของงาน ตัวเลขที่ระบบน่าจะทำได้ และเวลาที่วัดได้จากการซ้อมจริง ช่องว่างระหว่างสามอย่างนี้ต่างหากที่ใช้ตัดสินใจว่าจะลงทุนเพิ่ม ทำทางชั่วคราว หรือตกลงรับความเสี่ยง
ซ้อมครั้งแรกให้เล็กพอที่จะกล้าทำ
การทดสอบที่ใหญ่เกินความพร้อมมักถูกเลื่อนออกไปเรื่อย ๆ ขณะที่การกู้ไฟล์หนึ่งไฟล์แบบไม่ตรวจต่อก็เล็กจนตอบอะไรแทบไม่ได้ จุดเริ่มที่กำลังดีอาจเป็น “กู้เอกสารลูกค้า 20 ไฟล์จากสำเนาเมื่อคืนไปยังเครื่องทดสอบ” หรือ “กู้สำเนา database แล้วให้เจ้าของระบบเปิดรายงานหนึ่งรายการ”
ก่อนเริ่ม เขียนกระดาษสั้น ๆ ให้ตอบได้หกเรื่อง:
- สมมติว่าอะไรหาย และรอบนี้จะกู้อะไร
- ใช้สำเนาจากเวลาใด และกู้ไปไว้ที่ไหน
- ใครเป็นคนลงมือ ใครตรวจว่างานใช้ได้ และใครมีสิทธิ์สั่งหยุด
- พื้นที่ทดสอบแยกจาก production อย่างไร รวมถึงจะลบข้อมูลทดสอบเมื่อไร
- คาดว่าจะใช้เวลานานเท่าไร และยอมย้อนข้อมูลกลับได้ถึงจุดไหน
- จะเห็นอะไรจึงนับว่าผ่าน เช่น เปิดไฟล์ครบ ตรวจยอดตรง หรือสร้างรายงานตัวอย่างได้
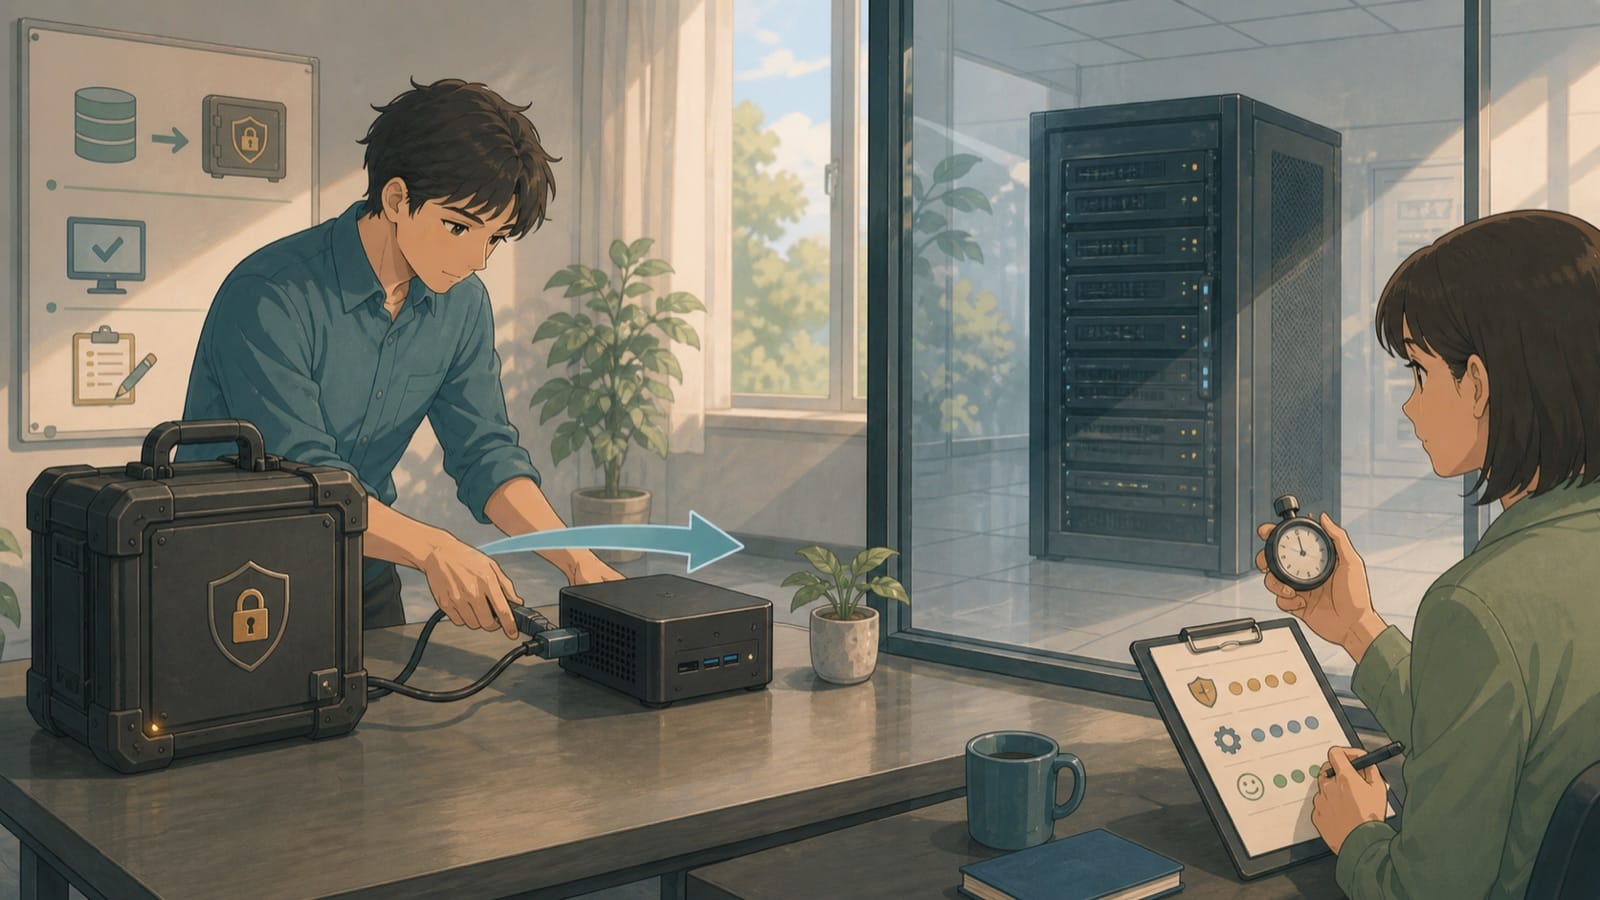
ระหว่างซ้อม ให้ผู้ลงมือทำตามเอกสารที่ทีมมีจริง ถ้าต้องโทรถามรหัสผ่าน จำลำดับการเปิด service เอง หรือค้นหาไฟล์ configuration จากแชตเก่า ให้บันทึกไว้ตามที่เกิดขึ้น อย่าเพิ่งช่วยกันทำให้ผลสวย เพราะความติดขัดเหล่านี้คือสิ่งที่เราต้องการพบตอนยังไม่รีบ
ส่วน production ควรเป็นเส้นห้ามข้ามของการซ้อมครั้งแรก เครื่องทดสอบไม่ควรเขียนกลับระบบจริง และข้อมูลที่กู้คืนต้องได้รับการป้องกันตามระดับความอ่อนไหวเดิม หากแยกพื้นที่ให้ปลอดภัยไม่ได้ การหยุดแล้วกลับไปออกแบบใหม่ถือเป็นผลทดสอบที่ดี ไม่ใช่ความล้มเหลว
แนวทางของ NIST SP 800-34 Rev. 1 แยกการทดสอบและการฝึกหลายระดับ ตั้งแต่การทบทวนแผนไปจนถึงการทดสอบเชิงปฏิบัติ ทีมเล็กจึงไม่จำเป็นต้องกระโดดไปทำ full failover ตั้งแต่รอบแรก ความลึกควรเพิ่มตามความสำคัญของระบบและความพร้อมที่จะควบคุมผลกระทบ
ไฟล์เปิดได้ แล้วงานกลับมาหรือยัง
หลัง restore เสร็จ ผมจะไม่หยุดที่การดับเบิลคลิกไฟล์หนึ่งไฟล์แล้วเห็นว่าเปิดได้ เพราะนั่นตรวจเพียงชิ้นส่วนเดียว ลองตามเส้นทางของระบบออก invoice ต่อไป:
- ข้อมูลกลับมาถูกจุดหรือไม่ — รอบ backup ตรงกับ RPO หรือมีข้อมูลขาดช่วง จำนวนเอกสาร วันที่ และยอดตัวอย่างตรงกับหลักฐานที่เชื่อถือได้หรือเปล่า
- งานสำคัญทำต่อได้หรือไม่ — application เริ่มทำงาน ผู้ใช้ที่ได้รับมอบหมายเปิดรายงานหรือทำรายการตัวอย่างได้ และสิทธิ์ยังเหมาะสมหรือไม่
- ต้องพึ่งอะไรที่ไม่ได้อยู่ใน backup บ้าง — เช่น DNS, identity, licence, encryption key, object storage, configuration, vendor หรือคนที่รู้ขั้นตอนเพียงคนเดียว
สามคำถามนี้ทำให้เห็นความต่างระหว่างการกู้ “ข้อมูล” กับการกู้ “บริการ” ได้ชัดขึ้น ระบบบางแบบอาจจบที่การตรวจไฟล์ตัวอย่าง ส่วนระบบที่มีหลาย dependency ควรมีทั้ง sample restore, database restore และการทดสอบ workflow ในคนละรอบ ไม่ต้องยัดทุกอย่างเข้า drill ครั้งเดียว
ใครควรเป็นคนบอกว่ากู้สำเร็จ
คนดูแล backup ยืนยันได้ว่าไฟล์ถูกดึงกลับมาและ process ไม่ขึ้น error แต่ไม่ควรเป็นคนเดียวที่ตัดสินว่าธุรกิจพร้อมทำงาน เจ้าของงานควรเลือกสิ่งที่จะตรวจและยืนยันผล เช่น ฝ่ายบัญชีตรวจรายงานและยอดตัวอย่าง หรือผู้ดูแลเอกสารยืนยันว่า permission และเวอร์ชันของไฟล์ยังถูกต้อง
ทีมเล็กอาจให้คนหนึ่งถือหลายหน้าที่ได้ ไม่มีปัญหาครับ ขอเพียงเขียนให้ชัดว่าใครดู job และ alert ใครเป็นผู้นำการซ้อม และใครรับรองผลในมุมงานจริง จุดที่ควรระวังคือประโยคว่า “vendor ดูแลให้” เพราะบางสัญญาครอบคลุมพื้นที่สำรอง แต่ไม่ได้ครอบคลุมเวลาที่ใช้กู้ การประกอบ application กลับมา หรือการตรวจว่าธุรกิจใช้งานต่อได้
จบด้วยงานแก้หนึ่งชุด ไม่ใช่รายงานหนา ๆ
หลังซ้อม เอกสารหนึ่งหน้าก็พอถ้าช่วยให้ทีมลงมือแก้ต่อได้ บันทึกว่าสำเนาจากเวลาใดถูกนำมากู้ เริ่มเมื่อไร ข้อมูลพร้อมเมื่อไร และเจ้าของงานยืนยันเมื่อไร จากนั้นแยกให้ชัดว่าอะไรผ่าน อะไรติด และอะไรยังอยู่นอกขอบเขต
ทุกช่องว่างควรจบด้วยคนรับผิดชอบและวิธีตรวจปิดงาน เช่น ย้าย encryption key ไปยังที่เก็บที่อนุมัติ เพิ่มขั้นตอนกู้ไฟล์แนบในเอกสาร หรือทดลองโดยให้คนสำรองเป็นผู้ลงมือรอบหน้า ผมชอบดู “อายุของการทดสอบล่าสุด” และ “งานแก้ที่ยังค้าง” มากกว่านับจำนวน backup job สีเขียว เพราะสองอย่างแรกบอกความพร้อมได้ใกล้ความจริงกว่า แนวคิดเรื่อง metric ที่ต้องนำไปสู่การตัดสินใจอ่านต่อได้ใน Cybersecurity Metrics สำหรับทีมเล็ก
ความถี่ไม่จำเป็นต้องเท่ากันทุกระบบ งานสำคัญและเปลี่ยนบ่อยอาจซ้อมแบบตัวอย่างทุกเดือนหรือทุกไตรมาส แล้วค่อยทำ functional drill ที่ลึกขึ้นตามความเสี่ยง ส่วน archive ที่แทบไม่เปลี่ยนอาจทดสอบหลังย้ายระบบหรือปีละครั้ง สิ่งที่ช่วยมากคือกำหนด trigger ไว้ล่วงหน้า เช่น หลังเปลี่ยน application, backup provider, encryption key หรือโครงสร้างพื้นฐาน แทนที่จะรอให้ใครสักคนนึกขึ้นได้
Restore drill ไม่ได้ให้คำรับประกันว่าจะผ่านทุกเหตุการณ์ และยังแทนการแยก backup, incident response หรือ business continuity ไม่ได้ แต่การกู้ระบบเล็ก ๆ ให้ครบหนึ่งรอบจะเปลี่ยนคำว่า “น่าจะกู้ได้” ให้เป็นหลักฐานที่จับต้องได้ พร้อมรายการช่องว่างที่ทีมแก้ต่อได้จริง นั่นมีค่ากว่าการซื้อพื้นที่เพิ่มทั้งที่ยังไม่เคยเปิดสำเนาออกมาดูครับ
อ่านต่อที่เกี่ยวข้อง
- Backup 3-2-1 แบบเข้าใจง่าย
- 3-2-1 Backup Strategy สำหรับ Homelab
- Cybersecurity Metrics สำหรับทีมเล็ก
- Incident Communication สำหรับทีมเล็ก