ใช้ Claude Code ทำเว็บขึ้น AWS จะเลือกทาง Deploy แบบไหนดี
จากเว็บ Project Tracker ที่รันบนเครื่อง สู่การเลือก EC2 หรือแยกบริการบน AWS ชวนดูค่าใช้จ่าย สิทธิ์ของ AI ฐานข้อมูล และทางกู้ระบบก่อนเปิดให้คนใช้งานจริง
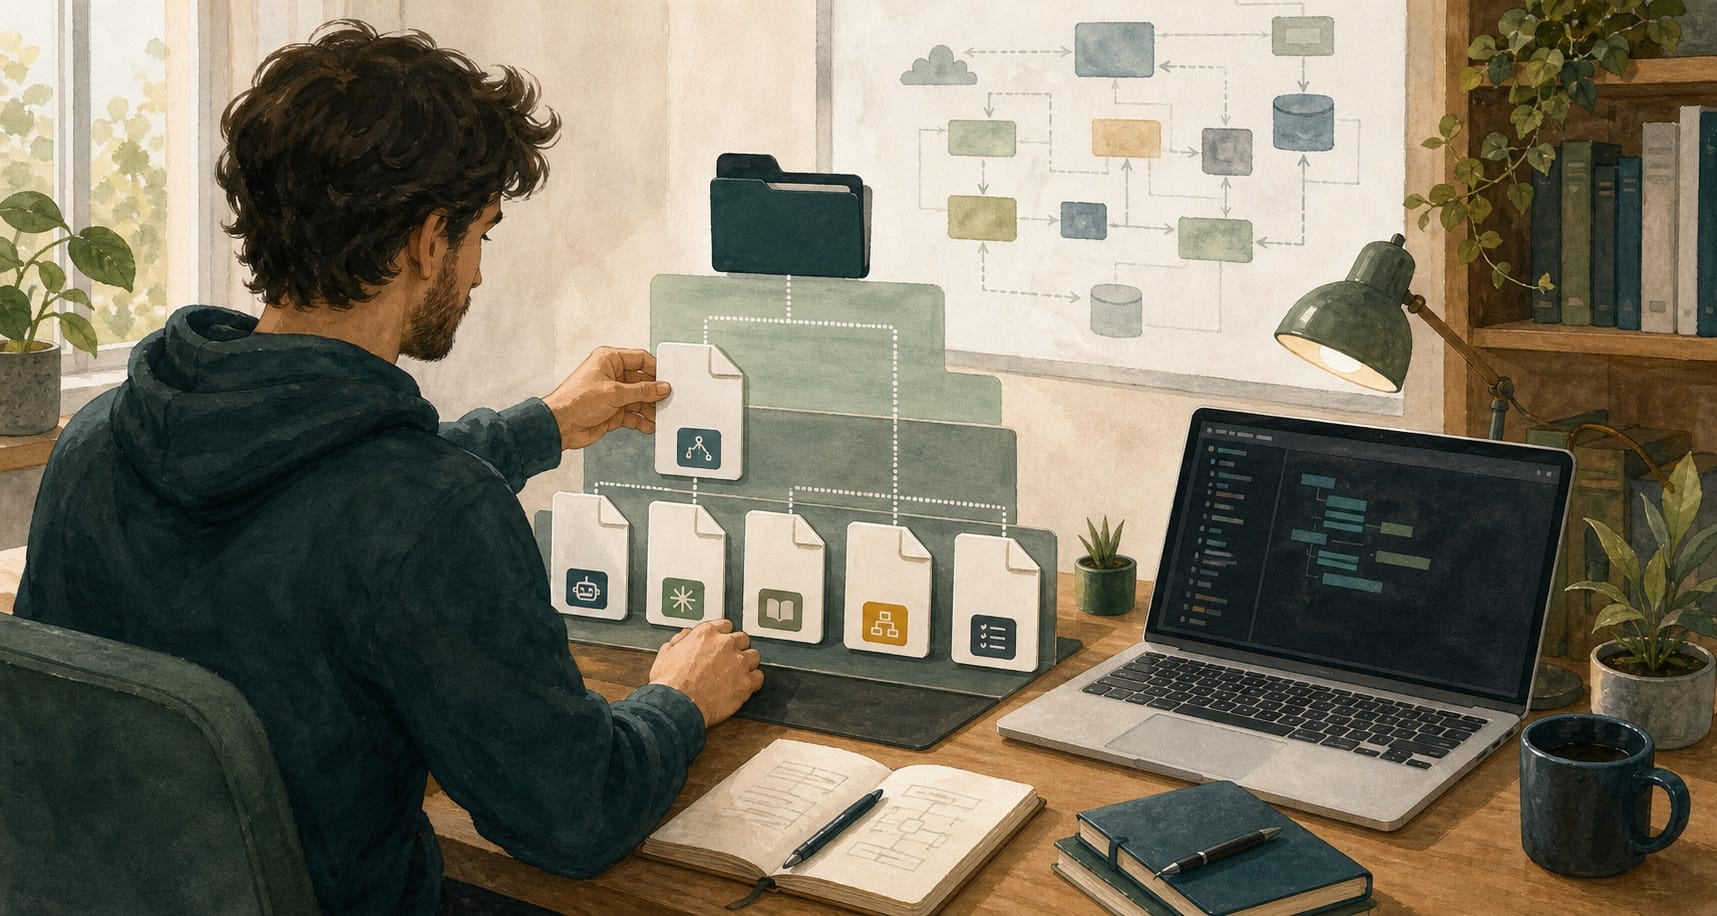
เว็บที่เปิดบนเครื่องเราได้แล้ว จะพาขึ้น AWS แบบไหนถึงจะดูแลต่อไหวครับ โดยเฉพาะเมื่อใช้ Claude Code ช่วยเขียนจนมีทั้งหน้าจอ API และฐานข้อมูลครบ การสร้าง server อาจดูเหมือนเป็นงานสุดท้ายที่เหลือ แต่พอเปิดให้คนอื่นใช้ เราจะต้องตัดสินใจเพิ่มว่าข้อมูลอยู่ตรงไหน ใครมีสิทธิ์เปลี่ยนระบบ และถ้ารุ่นใหม่มีปัญหาจะกลับไปทำงานต่ออย่างไร
คู่มือ สร้างและ Deploy เว็บแอป Full-Stack บน AWS ด้วย Claude Code ฉบับปรับปรุง 2.0 ใช้เว็บ Project Tracker เป็นตัวอย่าง มีรายการโครงการ งานย่อย และสถานะงาน เป็นขนาดที่เห็นการทำงานครบโดยไม่ต้องเริ่มจากระบบใหญ่ บทความนี้หยิบตัวอย่างนั้นมาเดินตามการตัดสินใจก่อน deploy เพื่อให้เลือกโครงสร้างที่เหมาะกับงานและภาระดูแลของตัวเองได้
ถ้าเป็นผม ผมจะเริ่มจากแยกว่า Project Tracker นี้มีไว้ฝึกหรือจะใช้เก็บงานจริง เพราะคำตอบเปลี่ยนทั้งงบประมาณและวิธีดูแลฐานข้อมูล เว็บทดลองที่ลบทิ้งแล้วสร้างใหม่ได้ กับเว็บที่คนในทีมต้องเปิดดูงานทุกเช้า อาจใช้โค้ดชุดเดียวกัน แต่ผมจะให้น้ำหนักกับทางกู้ข้อมูลต่างกันมาก
ก่อนเลือก server ผมอยากเห็นทางเดินของงานหนึ่งรายการ
ลองตามงานง่าย ๆ คือเปิดเว็บแล้วเพิ่ม task เข้าไปในโครงการ หน้าจอที่ผู้ใช้เห็นเป็นส่วน frontend ในคู่มือใช้ React กับ Vite ส่วน backend ใช้ Node.js กับ Fastify รับคำขอ ตรวจข้อมูล และทำงานกับ PostgreSQL ผ่าน Prisma ซึ่งช่วยจัดการการอ่านเขียนข้อมูลและโครงสร้างฐานข้อมูล
แปลเป็นภาพใกล้ตัวได้ว่า browser ส่งคำขอเพิ่มงานไปยัง API แล้ว API จึงบันทึกลงฐานข้อมูล browser ไม่ควรถือรหัสผ่าน PostgreSQL หรือเชื่อมต่อฐานข้อมูลโดยตรง ตัวแปรที่ฝังไปกับ frontend ก็ต้องคิดว่าเป็นข้อมูลที่ผู้ใช้ดูได้ จึงเหมาะกับที่อยู่ API มากกว่าความลับของระบบ
ส่วนชื่อเว็บก็มีหน้าที่แยกกัน ผู้รับจดโดเมน เช่น Hostinger ในคู่มือ ดูแลการจดและต่ออายุชื่อ Cloudflare ดูแล DNS ซึ่งบอกว่าชื่อนี้ต้องไปที่ไหน และอาจเป็นทางผ่านของทราฟฟิกเว็บ ส่วน AWS เป็นที่รันแอป การซื้อชื่อโดเมนจึงยังไม่ทำให้มีเครื่องสำหรับรัน backend ขึ้นมาเอง
ผมจะเขียนทางเดินนี้ลงกระดาษก่อน: ผู้ใช้เปิด www.example.com เรียก API ที่ api.example.com แล้ว API ติดต่อ PostgreSQL จากนั้นระบุว่าแต่ละส่วนอยู่กับบริการใด เมื่อเพิ่ม task ไม่สำเร็จ เราจะได้มีทางไล่ตรวจจากหน้าจอไปถึงข้อมูล แทนที่จะเดาว่าเป็นปัญหาที่ “cloud” ทั้งก้อน
เครื่องเดียวเริ่มง่าย แต่ข้อมูลก็อยู่กับเครื่องนั้นด้วย
ทางแรกของคู่มือคือ EC2 กับ Docker Compose โดย EC2 เป็นเครื่องเสมือนที่เราเช่า ส่วน Docker Compose ช่วยจัดการ container หลายตัวบนเครื่องนั้น เช่น API กับ PostgreSQL และใช้ Nginx รับคำขอจากภายนอกก่อนส่งเข้าแอป
ถ้า Project Tracker มีไว้เรียนรู้ ผมชอบทางนี้ตรงที่ตามระบบได้ในที่เดียว เห็นไฟล์ตั้งค่า ดู log และเข้าใจว่าหน้าจอคุยกับ API อย่างไร ยังไม่ต้องทำความรู้จักบริการจำนวนมากพร้อมกัน ข้อแลกเปลี่ยนคือเราเป็นคนดูแลการอัปเดตเครื่อง พื้นที่ disk และฐานข้อมูลเองทั้งหมด
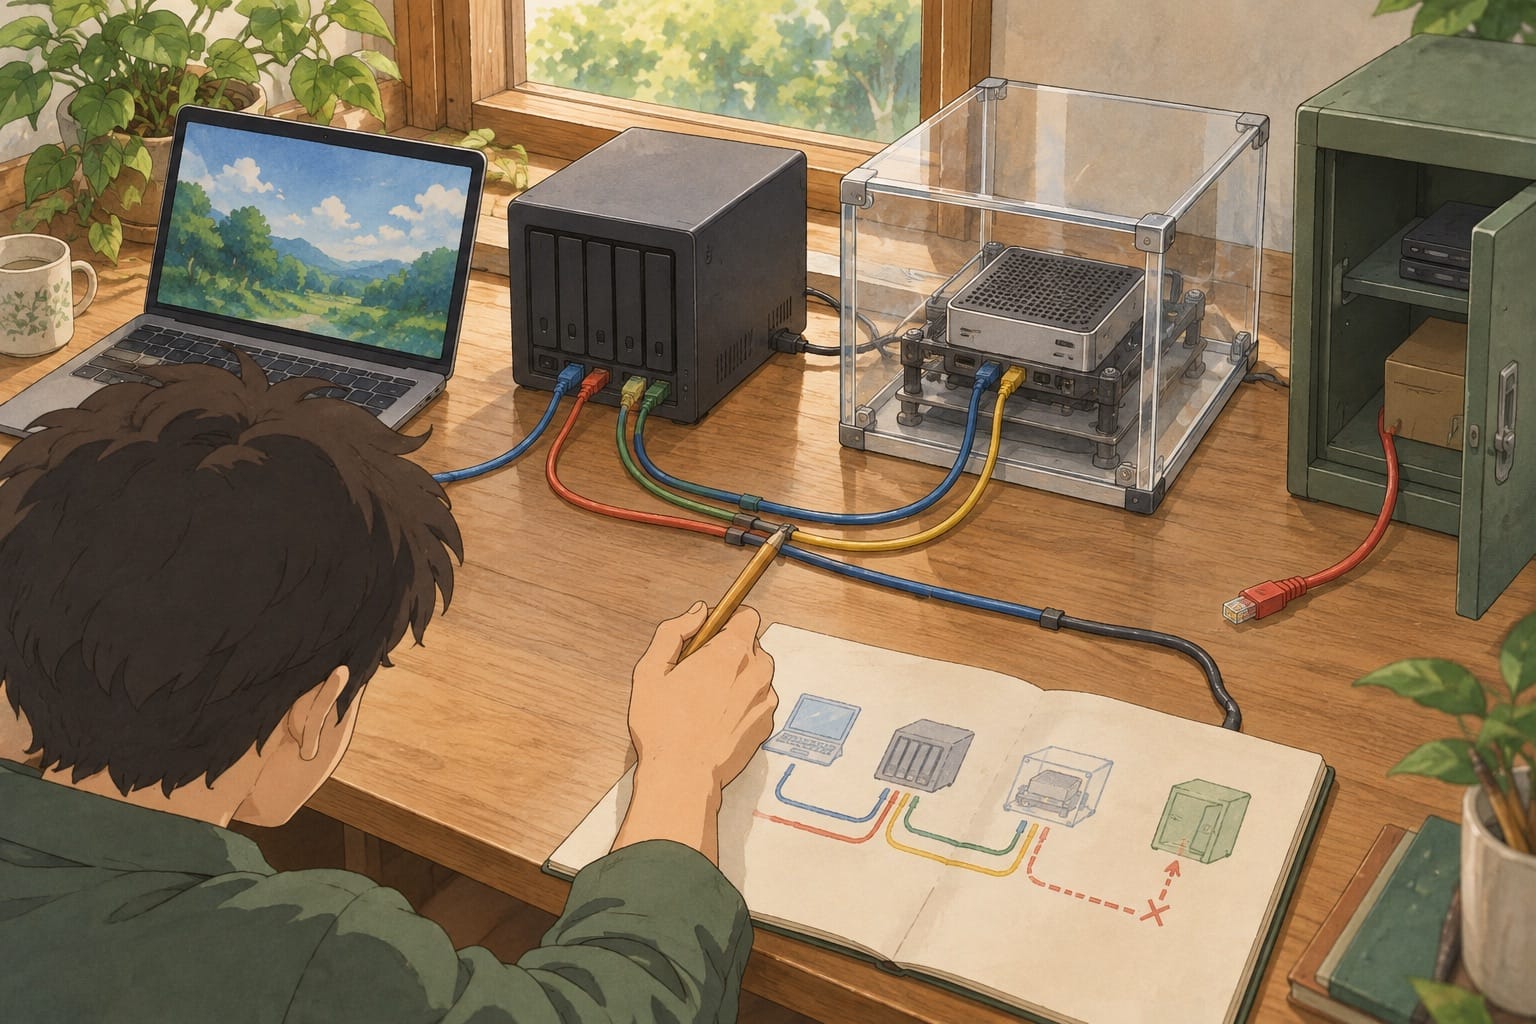
จุดที่ผมจะหยุดคิดนานขึ้นคือ PostgreSQL ถ้าข้อมูลอยู่ใน Docker volume บนเครื่องเดียวกับ API การเก็บข้อมูลให้ข้ามการสร้าง container ใหม่ได้ก็มีประโยชน์ แต่ volume นั้นยังอยู่ในขอบเขตความเสียหายของเครื่องและ storage ชุดเดิม ต้องมีสำเนาที่กู้ได้อยู่นอกเครื่อง พร้อมลองกู้ในพื้นที่แยกด้วย
คำว่า “เริ่มง่าย” จึงต้องรวมงานหลัง deploy เข้าไปด้วย ถ้าผู้ดูแลไม่ถนัดสำรองและกู้ PostgreSQL ผมจะยังไม่เอารายการงานจริงของทีมลงไป เพียงเพราะหน้าเว็บเปิดได้แล้ว ยอมใช้ข้อมูลตัวอย่างฝึกต่ออีกหน่อยดีกว่าต้องเรียนวิธีกู้ในวันที่ข้อมูลหายครับ
อีกทางคือแยกส่วน: frontend ไป AWS Amplify Hosting, backend อยู่ EC2 หรือ ECS และ PostgreSQL ไป Amazon RDS การแยกแบบนี้ช่วยให้เปลี่ยนเครื่องที่รัน API โดยไม่ต้องย้ายฐานข้อมูลไปพร้อมกัน และใช้ความสามารถสำรองข้อมูลของบริการฐานข้อมูลได้ตามที่ตั้งค่าไว้ แต่ก็มีบริการ สิทธิ์ และค่าใช้จ่ายให้ตามเพิ่ม
ถ้า Project Tracker กำลังจะเป็นเครื่องมือทำงานจริง ผมจะพิจารณาแยกฐานข้อมูลก่อน ส่วน backend อาจยังเป็น EC2 ได้ ไม่จำเป็นต้องเปลี่ยนทุกส่วนไปเป็นโครงสร้างใหญ่พร้อมกัน สิ่งที่ยอมจ่ายเพิ่มคือภาระดูแลฐานข้อมูลบางส่วนที่บริการช่วยรับไป ส่วนสิทธิ์เข้าถึง ระยะเก็บ backup และการทดสอบกู้ยังต้องตัดสินใจเอง
สำหรับ RDS ผมจะเริ่มจากฐานข้อมูลที่ไม่เปิดให้เข้าจากอินเทอร์เน็ตโดยตรง แล้วใช้ Security Group ซึ่งเป็นกฎควบคุมการเชื่อมต่อ อนุญาตเฉพาะ backend ที่ต้องใช้ข้อมูล การตั้ง private subnet ต้องดูเส้นทางเครือข่ายควบคู่กันด้วย ไม่ใช่แค่ตั้งชื่อ subnet ว่า private แล้วถือว่าจบ เอกสาร RDS อธิบายการเข้าถึงฐานข้อมูลใน VPC และ Security Group ไว้ที่นี่
งบหลังหมดเครดิต สำคัญกว่าคำว่า Free Tier
ก่อนสร้างเครื่อง ผมจะเปิดหน้าค่าใช้จ่ายใน AWS แล้วดูว่า account นี้ใช้แผนใด มีเครดิตเท่าไร และสิทธิ์หมดเมื่อไร ปัจจุบันบัญชีใหม่ตามเงื่อนไข AWS Free Tier ที่เริ่มใช้ตั้งแต่ 15 กรกฎาคม 2025 ได้เครดิตเริ่มต้น 100 ดอลลาร์ และมีโอกาสรับเพิ่มอีกสูงสุด 100 ดอลลาร์ ส่วน Free Plan ใช้ได้สูงสุดหกเดือนหรือจนเครดิตหมด แล้วแต่ว่าอะไรถึงก่อน จึงไม่ควรเอาความเข้าใจเรื่องใช้ฟรี 12 เดือนจากบัญชีรุ่นเก่ามาใช้กับทุกบัญชี อ้างอิงประกาศ AWS Free Tier
สำหรับ Project Tracker ผมจะประมาณงบจากส่วนที่ตั้งใจเก็บไว้หลังทดลอง: เครื่องรัน API, ฐานข้อมูล, storage, backup และทราฟฟิก รวมบริการประกอบอย่าง public IPv4, load balancer หรือ NAT Gateway ถ้าเลือกใช้ ราคาจริงต้องดู region และรูปแบบการใช้งาน ไม่หยิบตัวเลขตัวอย่างในคู่มือมาตั้งเป็นราคาตายตัวของระบบเรา
สิ่งที่อยากได้คือคำตอบว่า หลังเครดิตหมดแล้วยังยอมจ่ายเพื่อให้เว็บนี้อยู่ต่อไหม ถ้าคำตอบคือไม่ ผมจะกำหนดวันเลิกทดลองกับรายการทรัพยากรที่ต้องลบตั้งแต่แรก การหยุดใช้งานหน้าเว็บไม่ได้แปลว่า storage, snapshot หรือบริการเครือข่ายหมดค่าใช้จ่ายตามไปด้วย
AWS Budgets ช่วยแจ้งเตือนเมื่อค่าใช้จ่ายหรือยอดคาดการณ์ถึงเกณฑ์ที่ตั้งไว้ แต่การตั้ง alert อย่างเดียวไม่ได้สั่งหยุดทุกบริการให้อัตโนมัติ ต้องมีคนรับแจ้งเตือนและรู้ว่าจะตรวจอะไรต่อ ผมจะส่งเข้ากล่องอีเมลที่เปิดอ่านจริง และทบทวนงบอีกครั้งเมื่อเปลี่ยนจากเครื่องเดียวไปเป็นหลายบริการ ดูความสามารถและข้อจำกัดของ AWS Budgets
ให้ Claude Code ช่วยเร็วขึ้น โดยรู้ว่ามันแตะอะไรได้
เมื่อรู้ว่าจะวาง Project Tracker แบบไหนแล้ว ค่อยให้ Claude Code ช่วยทำงานเป็นช่วง คู่มือเสนอให้เริ่มจากอ่าน repository และเสนอแผนก่อนแก้ไฟล์ ซึ่งผมมองว่าเหมาะกับจังหวะนี้ เพราะต้องเห็นทั้งส่วนที่แก้และผลกระทบก่อนให้มันเดินต่อ
ตัวอย่างคำขอที่ผมจะใช้คือ:
อ่านโครงสร้าง Project Tracker แล้วเสนอแผน deploy สำหรับทีมเล็ก แยกส่วนที่ต้องเปลี่ยนใน frontend, backend และฐานข้อมูล ระบุค่าใช้จ่ายที่ต้องตรวจ พร้อมวิธีทดสอบและทางกลับเมื่อรุ่นใหม่มีปัญหา ยังไม่แก้ไฟล์หรือสร้างทรัพยากร
ใน CLAUDE.md เราอธิบายโครงสร้างโปรเจกต์ คำสั่งทดสอบ ตำแหน่งไฟล์ตัวอย่าง และกติกาว่าการเปลี่ยนฐานข้อมูลต้องผ่านการตรวจอย่างไรได้ ผมชอบไฟล์แบบนี้ตรงที่ลดการอธิบายบริบทซ้ำ แต่ต้องแยกมันออกจากสิทธิ์จริงของเครื่องมือ Anthropic ระบุว่าข้อความใน prompt หรือ CLAUDE.md ชี้นำสิ่งที่ Claude พยายามทำ ส่วน permission rules เป็นสิ่งที่ Claude Code ใช้ควบคุมการอนุญาต อ้างอิง Claude Code permissions
ถ้าขอให้ AI รีวิวไฟล์ตั้งค่า ผมจะให้มันอยู่ในสภาพแวดล้อมพัฒนาที่ไม่จำเป็นต้องมี credential ของ production ก่อน อย่าเพิ่มสิทธิ์ admin เพียงเพราะมันบอกว่าคำสั่งหนึ่งรันไม่ได้ ควรกลับมาดูว่ากำลังต้องทำอะไรและต้องใช้สิทธิ์ส่วนไหนจริง
ฝั่ง AWS ก็แยกตัวตนของคน เครื่อง server และระบบ deploy ออกจากกัน คนเปิด MFA และใช้สิทธิ์ชั่วคราวเมื่อทำได้ ส่วน workload ใช้ IAM role ตามงานที่ต้องทำ แนวทางนี้สอดคล้องกับ AWS IAM best practices ถ้าใช้ GitHub Actions ทำ deploy การใช้ OIDC ช่วยให้ workflow ขอ credential ชั่วคราวได้ โดยต้องจำกัดเงื่อนไขให้ตรง repository และ branch หรือ environment ที่อนุญาตด้วย
ในทางปฏิบัติ ผมอยากให้ขั้นทดสอบรันได้โดยไม่ถือสิทธิ์ deploy และให้ขั้น deploy ทำงานจากรุ่นที่ผ่านการตรวจแล้ว จะได้ไม่เอาการรันโค้ดทดสอบกับการเปลี่ยนระบบจริงมาผูกอยู่กับกุญแจชุดเดียวกัน
เว็บเปิดได้แล้ว ยังต้องลองเพิ่มงานจากโดเมนจริง
หลัง deploy ผมจะกลับไปทำงานเดิมคือเปิด Project Tracker แล้วเพิ่ม task ผ่านโดเมนจริง นี่ช่วยตรวจได้มากกว่าการเห็นหน้าแรก เพราะคำขอต้องผ่านชื่อโดเมน HTTPS, API และฐานข้อมูลครบ แล้วลองเปิดใหม่เพื่อยืนยันว่ารายการถูกเก็บอยู่จริง
ถ้าใช้ Cloudflare proxy ต้องตรวจ HTTPS ทั้งช่วง browser ถึง Cloudflare และ Cloudflare ถึงเครื่องปลายทางด้วย โหมด Full (strict) ตรวจ certificate ของ origin ตามเงื่อนไขที่กำหนด ดังนั้นต้องเตรียม certificate ฝั่งนั้นให้ถูกต้องก่อนใช้งาน ผมจะไม่แก้ปัญหาด้วยการลดระดับการตรวจ certificate เพียงเพื่อให้หน้าเว็บหาย error ดูเงื่อนไข Full (strict) ของ Cloudflare
เมื่อ frontend กับ API อยู่คนละชื่อ เช่น www กับ api ก็ต้องตั้ง CORS ให้รองรับ origin ที่ใช้จริง ซึ่งเป็นกฎว่าหน้าเว็บจากที่ใดอ่านคำตอบของ API ผ่าน browser ได้ แต่ CORS ไม่ได้ใช้แทนการล็อกอินหรือการตรวจสิทธิ์ backend ยังต้องตรวจว่าคนนี้อ่านและแก้งานของโครงการใดได้ การทดสอบจึงควรมีทั้งคนที่มีสิทธิ์และคนที่ไม่มีสิทธิ์ ไม่ใช่ลองด้วยบัญชี admin อย่างเดียว
ส่วน /health มีไว้บอกสถานะให้ระบบตรวจรู้ว่าแอปยังพร้อมทำงานหรือไม่ แต่คำตอบว่าแอปยังตอบได้ไม่พอจะยืนยันว่ากระบวนการเพิ่มงานสำเร็จ ต้องดู log และทดสอบงานหลักควบคู่กัน ถ้าแสดงสถานะ health สู่ภายนอกก็ไม่ควรเปิดเผยรหัสผ่านหรือรายละเอียดภายในที่ไม่จำเป็น
ผมจะเริ่ม monitoring จากอาการที่กระทบ Project Tracker จริง เช่น เพิ่มงานไม่สำเร็จ API ตอบช้าขึ้น พื้นที่ฐานข้อมูลใกล้เต็ม และค่าใช้จ่ายผิดจากที่คาด แล้วค่อยปรับเกณฑ์เตือนจากข้อมูลใช้งาน แทนการยก threshold ตัวอย่างในคู่มือมาใช้โดยไม่ดูว่าทีมรับความช้าหรือเวลาหยุดได้เท่าไร
ทางกลับต้องคิดถึงข้อมูลที่เพิ่งเพิ่มด้วย
สมมติว่า Project Tracker รุ่นใหม่เปลี่ยนวิธีเก็บสถานะงาน แล้วหน้าเว็บเริ่มบันทึกไม่ได้ การย้อนกลับไปใช้ container image รุ่นก่อนอาจช่วยได้ ถ้าโค้ดเก่ายังทำงานกับโครงสร้างฐานข้อมูลปัจจุบันได้ แต่ถ้ารุ่นใหม่ลบคอลัมน์ที่รุ่นเก่าต้องใช้ไปแล้ว การเปลี่ยน image อย่างเดียวก็ไม่ทำให้คอลัมน์กลับมา
คู่มือพูดถึง migration ซึ่งเป็นการเปลี่ยนโครงสร้างฐานข้อมูล และเสนอแนวทางเพิ่มของใหม่ก่อน ค่อยย้ายการใช้งาน แล้วจึงลบของเก่า ผมชอบวิธีนี้สำหรับการเปลี่ยนที่ทำเป็นระยะได้ เพราะช่วยเหลือพื้นที่ให้โค้ดเก่ากับใหม่อยู่ร่วมกันระหว่างเปลี่ยนรุ่น แต่ยังต้องอ่านสิ่งที่จะเปลี่ยนและลองกับข้อมูลทดสอบที่ใกล้เคียงของจริงก่อน
มีรายละเอียดหนึ่งที่ควรระวังเวลาอ่านตัวอย่าง rollback ของ Prisma: migrate resolve ใช้ปรับสถานะในประวัติ migration ไม่ได้ย้อนคำสั่ง SQL หรือคืนข้อมูลที่ลบไปเอง การกู้ต้องมีขั้นตอนแก้ schema หรือ restore ที่เหมาะกับความเสียหายและ Prisma รุ่นที่ใช้อยู่ เอกสาร Prisma อธิบายหน้าที่ของ migrate resolve ไว้ชัดเจน
ถ้าต้อง restore สำเนาก่อน deploy ก็ต้องคิดถึง task ที่คนเพิ่มหลังเวลาของสำเนานั้นด้วย ผมจะอยากรู้ว่าเรายอมเสียข้อมูลใหม่ได้มากเท่าไร ต้องหยุดการเขียนระหว่างกู้ไหม และจะตรวจหรือเก็บข้อมูลที่เกิดขึ้นภายหลังอย่างไร ก่อนเปิดให้ทีมกลับมาใช้งาน การมีไฟล์ backup จึงยังต้องตามด้วยการลองกู้และตรวจงานในพื้นที่แยก
ก่อนเปิด Project Tracker ให้คนใช้งานจริง ผมจะขอดูหลักฐานง่าย ๆ เหล่านี้:
- เพิ่มและเปิดดู task ผ่านโดเมนจริงได้ รวมถึงตรวจว่าคนไม่มีสิทธิ์ถูกปฏิเสธ
- ระบุได้ว่ารุ่นแอปนี้ใช้กับ schema ใด และรุ่นก่อนยังย้อนกลับมาใช้ได้ภายใต้เงื่อนไขอะไร
- มีสำเนาฐานข้อมูลที่เคยลองกู้แล้ว พร้อมรู้เวลาที่ใช้และช่วงข้อมูลที่อาจสูญเสีย
- คนดูแลรับทั้ง alert ระบบและค่าใช้จ่ายได้ และมีรายการทรัพยากรที่ต้องจัดการเมื่อเลิกทดลอง
ถ้าเป้าหมายคือฝึก ผมจะเริ่มจาก EC2 กับ Docker Compose แล้วใช้ข้อมูลตัวอย่างเดินให้ครบทั้ง deploy และกู้คืน แต่เมื่อจะเก็บงานจริง ผมจะให้น้ำหนักกับการแยกฐานข้อมูลและการกู้ที่ทำได้มากขึ้น แม้มีค่าใช้จ่ายเพิ่ม สำหรับ Project Tracker จุดที่ทำให้ผมพร้อมชวนคนอื่นเข้ามาใช้คือสามารถบอกได้ว่า ถ้ารุ่นถัดไปมีปัญหา งานของทีมจะกลับมาอยู่ตรงไหนและต้องรอนานเท่าไรครับ
อ่านต่อที่เกี่ยวข้อง
- ไฟล์ Context สำหรับ AI Coding Assistant สำหรับจัดข้อมูลโปรเจกต์ก่อนให้ AI ช่วยแก้โค้ด
- ซ้อมกู้ Backup สำหรับทีมเล็ก สำหรับเปลี่ยนจากมีสำเนาเป็นรู้ว่ากู้กลับมาทำงานได้
แหล่งเนื้อหา
บทความเรียบเรียงจากคู่มือ สร้างและ Deploy เว็บแอป Full-Stack บน AWS ด้วย Claude Code ฉบับปรับปรุง 2.0 ที่ได้รับมา โดยใช้ตัวอย่าง Project Tracker และแนวทางในหน้า 10-15, 19-21, 26-41 และ 50-53 ประกอบเอกสารทางการที่เชื่อมไว้ในเนื้อหา ตรวจข้อมูลบริการเพิ่มเติมวันที่ 6 ตุลาคม 2026 ตัวอย่างในบทความไม่ได้เป็นบันทึกการ deploy หรือผลทดสอบของผู้เขียน